Case study
Insolvenční právo. Unikátní přesnost: odkazy do primárních zdrojů a sémantické vyhledávání.
Výchozí stav
Insolvenční právníci potřebují odpovědi s prameny, ne hromady spisů. Judikatura a podání z insolvenčního rejstříku jsou roztroušené, často naskenované s rozbitou textovou vrstvou. Obecné jazykové modely odpovídají sebevědomě, ale bez primárního zdroje. Doména pro nás byla nová, tak jsme se ji nejdřív naučili.
Co jsme udělali
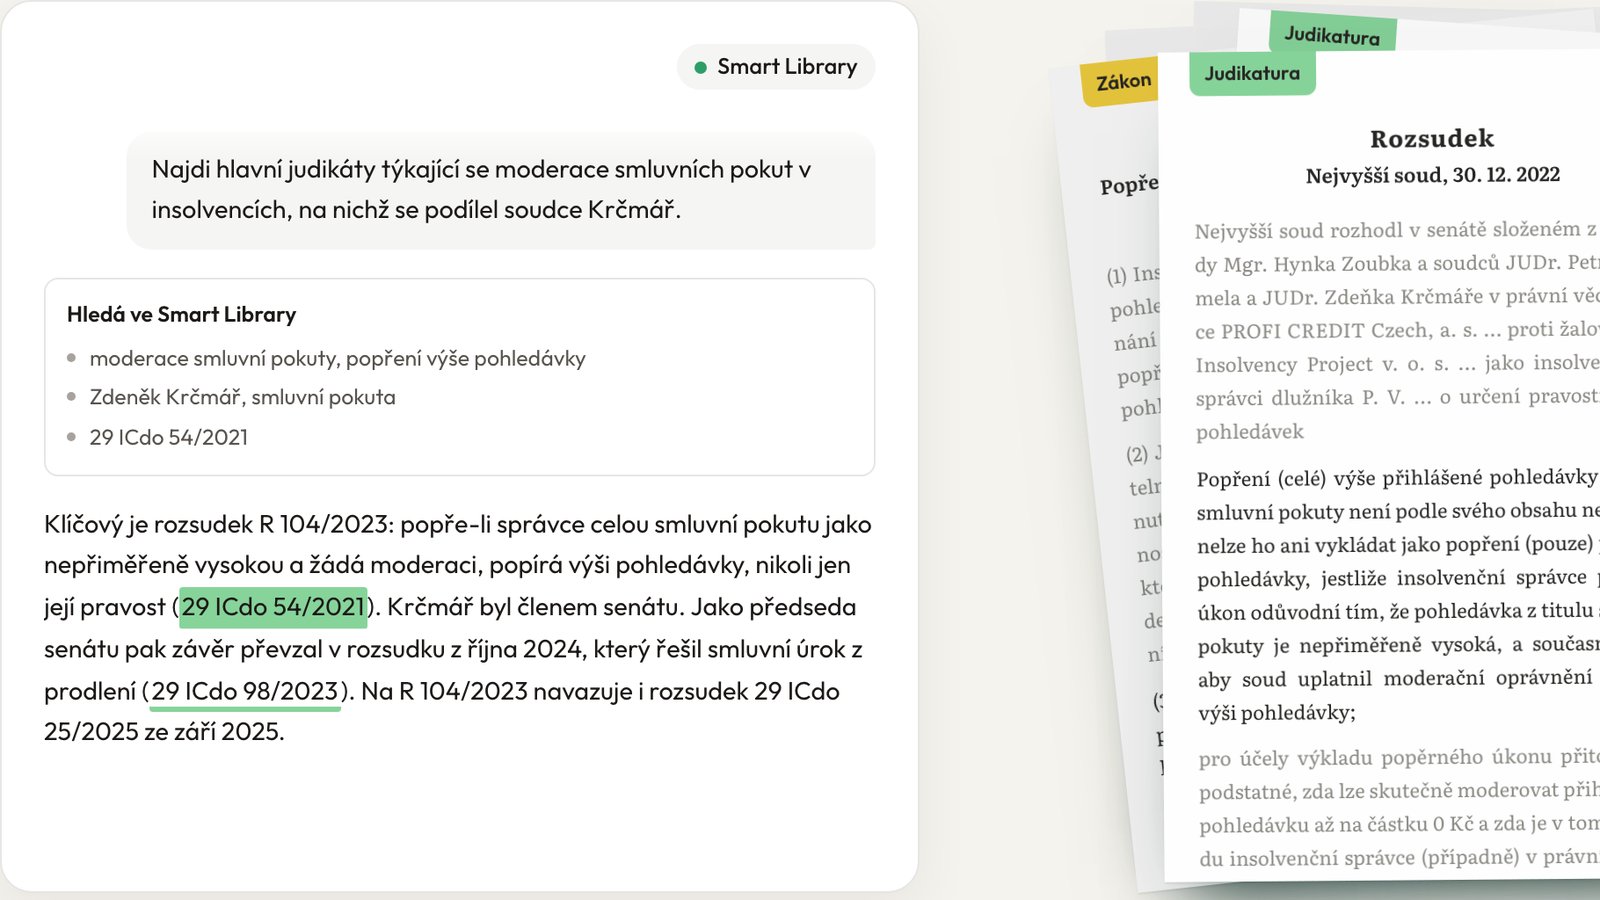
Znalostní báze českého insolvenčního práva: zákony z e-Sbírky, rozhodnutí Nejvyššího, Ústavního, vrchních a krajských soudů a podání z insolvenčního rejstříku. Při načítání opravujeme naskenovaná a poškozená PDF, kde je potřeba, i pomocí OCR. Hledá se podle významu i podle přesných identifikátorů, třeba spisových značek a paragrafů. Odpověď smí vycházet jen z nalezených pasáží a každé tvrzení cituje a otevře originál na zvýrazněném místě. Více modelů za jednou vrstvou, s kontrolou nákladů.
Produkt je MCP server: ke Claude nebo ChatGPT ho připojíte za dvě minuty, přihlásíte se přes Google nebo Apple, 14 dní zdarma. Pro použití bez nich má vlastní chat a prohlížeč dokumentů.
Výsledek
Přes 100 000 dokumentů (stav 10/2026): 5 135 rozhodnutí Nejvyššího soudu, 2 536 rozhodnutí vrchních a krajských soudů, 86 468 podání z insolvenčního rejstříku, 228 sledovaných spisů a 82 nálezů Ústavního soudu. MCP konektor je přihlášený do adresářů Claude a ChatGPT (11/2026). Běží ukázky v advokátních kancelářích.
Další krok
Řešíte něco podobného?
Inženýr odpoví do jednoho pracovního dne. Do týdne máte poctivý pohled na rozsah, riziko a cenu.